جلسه دفاع پایان نامه: آرزو شفیعی بافتی، گروه آبخیزداری
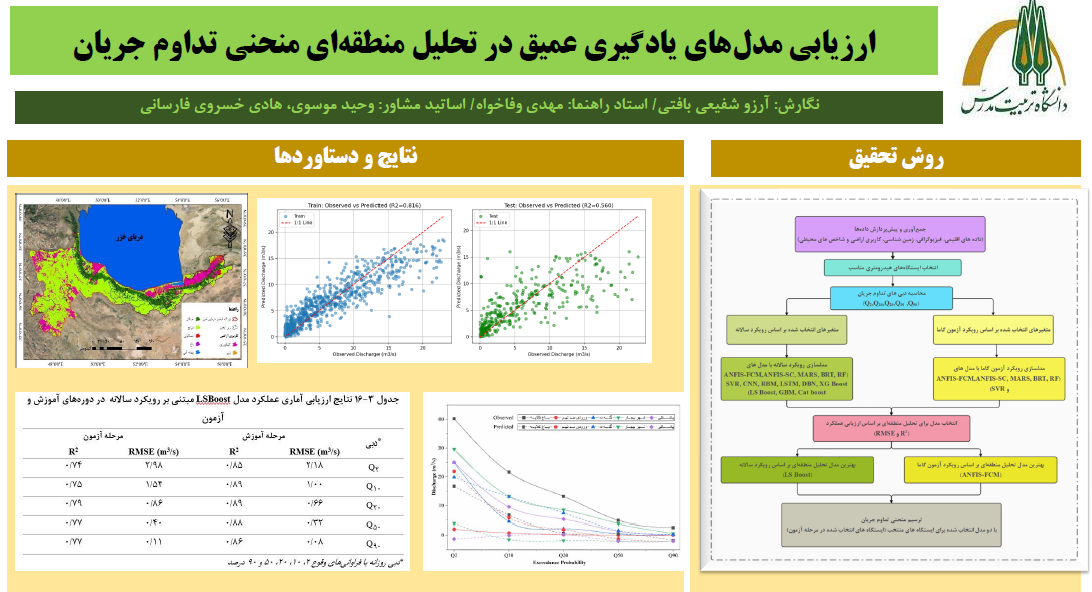
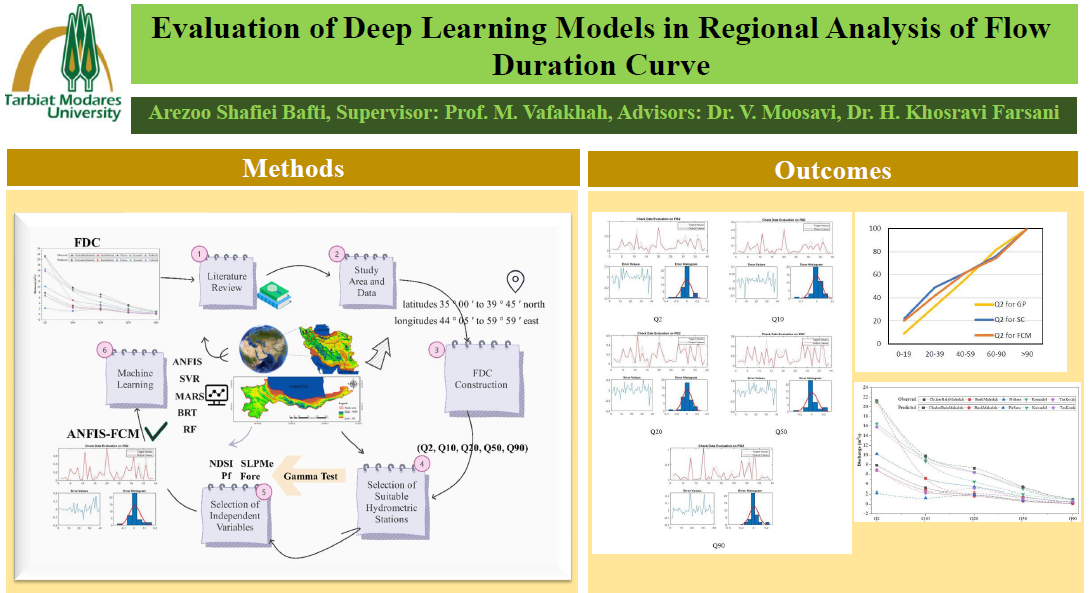
جلسه دفاع پایان نامه آرزو شفیعی بافتی با عنوان «ارزیابی مدل های یادگیری عمیق در تحلیل منطقه ای منحنی تداوم جریان» ۲۹ مهر ۱۴۰۵ برگزار میشود.
ارائه کننده: آرزو شفیعی بافتی
استاد راهنما: دکتر مهدی وفاخواه
استاد مشاور: دکتر وحید موسوی
استاد مشاور دوم: دکتر هادی خسروی فارسانی
استاد ناظر داخلی: دکتر حمیدرضا مرادی رکابدارکلائی، دکتر عبدالواحد خالدی درویشان
استاد ناظر خارجی: دکتر هیراد عبقری، دکتر باقر قرمزچشمه
نماینده تحصیلات تکمیلی: دکتر سیدحمیدرضا صادقی
تاریخ: ۱۴۰/۰۷/۲۹
ساعت: ۰۸:۰۰
مکان: سالن اصلی کاخ
چکیده:
با افزایش جمعیت و گسترش فعالیتهای انسانی، نیاز به منابع آب بهطور چشمگیری افزایش یافته است. ازاینرو، مدیریت منابع آب یکی از مهمترین موضوعات در حوزه مدیریت و برنامهریزی منابع آب و از الزامات اساسی توسعه اجتماعی و اقتصادی محسوب میشود. منحنی تداوم جریان (FDC) یکی از دادههای ارزنده و دارای اطلاعات مفید است که تمامی مقادیر دبی رودخانه، مانند جریانهای کمینه، بیشینه و شرایط عادی را نمایش میدهد. این منحنی در طراحی و بهرهبرداری از نیروگاههای برقآبی، ارزیابی کیفیت آب، ارزیابی وضعیت اکولوژیکی رودخانه، تعیین نیاز آبی محیطزیستی و ارزیابی کمی اثرات اقدامات آبخیزداری کاربرد دارد. بااینحال، بسیاری از حوزههای آبخیز در جهان فاقد ایستگاههای آبسنجی یا دارای آمار کوتاهمدت دبی هستند. با توجه به این موضوع، هیدرولوژیستها از روش تحلیل منطقهای بهره میگیرند. در این روش، متغیرهای هیدرولوژیکی حوزههای فاقد آمار بر اساس اطلاعات حوزههای دارای آمار برآورد میشوند. لذا پژوهش حاضر با هدف تحلیل منطقهای منحنی تداوم جریان در بزرگ حوزه آبخیز دریای خزر با استفاده از روشهای متداول (رگرسیونی) و هوشمند (دادهکاوی و یادگیری عمیق) انجام شد. برای نیل به اهداف پژوهش، ابتدا متغیرهای مستقل شامل ویژگیهای فیزیوگرافی، اقلیمی، زمینشناسی، کاربری اراضی و شاخصهای پوشش گیاهی و هیدرولوژیکی استخراج شدند و سپس بر اساس آزمون گاما، در رویکرد اول، متغیرهای ارتفاع متوسط، شیب میانگین، NDSI و درصد کاربری اراضی جنگلی و در رویکرد دوم، متغیرهای شیب میانگین حوزه آبخیز، دمای میانگین سالانه،NDSI و درصد کاربری اراضی مرتعی بهعنوان متغیرهای مستقل انتخاب شدند. در ادامه، منحنی تداوم جریان برای هر یک از ایستگاههای آبسنجی ترسیم شد و مقادیر دبی متناظر با فراوانیهای 2، 10، 20، 50 و 90 درصد در سالهای مختلف استخراج گردید. سپس این مقادیر با استفاده از روشهای متداول (رگرسیونی) و هوشمند (دادهکاوی و یادگیری عمیق) برآورد شدند. بهمنظور انتخاب مناسبترین مدل از نمایههای ریشه میانگین مربعات خطا (RMSE) و ضریب تعیین (R²) استفاده شد. نتایج نشان داد که در رویکرد بلندمدت (آزمون گاما)، مدل ترکیبی ANFIS-FCM با R² آزمون بین 75/0 تا 94/0 و RMSE آزمون بین 03/0 تا 07/0 بهعنوان برترین مدل معرفی شد، در حالیکه در رویکرد سالانه، مدل LSBoost با R² آزمون بین 74/0 تا 79/0 و RMSE آزمون بین 11/0 تا 03/2 بهترین عملکرد را در میان مدلهای یادگیری ماشین از خود نشان داد.